Agent ဆီက message လေး ဝင်လာတယ်။ "Fix ပြီးပါပြီ။ Test အားလုံး pass ပါတယ် ✅"
ကြည့်ရတာ အဆင်ပြေနေတော့ merge လုပ်မလို့ပဲ။ ဒါပေမယ့် တစ်ခါလောက် စမ်းကြည့်ချင်တာနဲ့ session အသစ်ဖွင့်ပြီး agent နောက်တစ်ခုကို line တစ်ကြောင်းချင်း ပြန်စစ်ခိုင်းလိုက်တယ်။
ထွက်လာတာက requirement ၅ ခုမှာ ၂ ခု မပါဘူး။ Test တစ်ခုဆို pass တာတောင် မဟုတ်ဘူး၊ skip သွားတာ။
Agent က လိမ်တာတော့ မဟုတ်ဘူး။ ကိုယ့်အိမ်စာ ကိုယ်ပဲ ပြန်စစ်နေတာ။ ဒီတော့ အမှတ်ကောင်းကောင်း ပေးမှာပေါ့။
ဘာလို့ "done" ကို အလွယ်တကူ ပြောကြတာလဲ
Code ရေးပြီးခါစ agent က ကိုယ့် context ထဲမှာ နစ်နေတယ်။ ဘာလုပ်ချင်ခဲ့လဲဆိုတာ ခေါင်းထဲမှာ ရှိနေတော့ diff ကို ပြန်ဖတ်လည်း ကိုယ်လုပ်ချင်ခဲ့တာကိုပဲ မြင်နေတာ။ ကိုယ်ရေးထားတဲ့စာကို ကိုယ်ပြန်ဖတ်ရင် အမှားမမြင်ရတာမျိုးပေါ့။
| Session အဟောင်းက စစ်ရင် | Session အသစ်က စစ်ရင် | |
|---|---|---|
| မြင်တာ | ဘာလုပ်ချင်ခဲ့လဲ၊ ကိုယ့် reasoning | Task နဲ့ diff ပဲ |
| "ငါရေးတာ" လို့ သိလား | သိတယ် | မသိဘူး |
| Checklist | မရှိဘူး | PASS/FAIL checklist |
| ဖတ်မိတာ | ရည်ရွယ်ချက် | တကယ်ရှိနေတာ |
ဒါက ကျွန်တော့် ကိုယ်တွေ့ပါ။ ဒီအကြောင်း လိုက်ဖတ်ကြည့်တော့ research တွေကလည်း အဲ့ဘက်ကိုပဲ ညွှန်နေတယ်။ ဒါပေမယ့် အစက ထင်ထားတာထက်တော့ ပိုရှုပ်တယ်။
- ပြင်ပက feedback မပါရင် ကိုယ့်ဘာသာ သိပ်မပြင်နိုင်သေးဘူး။ Google DeepMind ရဲ့ paper (ICLR 2024) မှာ LLM တွေကို ကိုယ့်အဖြေ ကိုယ်ပြန်ပြင်ခိုင်းတော့ external feedback မပါရင် သိပ်မပြင်နိုင်ဘူး၊ တစ်ခါတလေ ပြင်ပြီးမှ ပိုဆိုးသွားသေးတယ်။ 2025 မှာ ထွက်တဲ့ နောက်ဆက်တွဲ paper (ACL 2025) ကလည်း reasoning model တွေ အပါအဝင် model ၉ ခုကို programming ပါတဲ့ task တွေနဲ့ စမ်းကြည့်တော့ self-correction fail တာ အများကြီး ဆက်တွေ့နေတုန်းပဲ။ ခြွင်းချက်ကတော့ reinforcement learning နဲ့ self-correct လုပ်တတ်အောင် သီးသန့် train ထားတဲ့ model တွေက တကယ် ပိုကောင်းလာတယ်။
- Model တွေ ကိုယ့်အလုပ်ကို ဘက်လိုက်လား ဆိုတာကတော့ ငြင်းနေကြတုန်းပဲ။ NeurIPS 2024 paper တစ်ခုက LLM judge တွေ ကိုယ်ရေးတာကို လူတွေထက် ပိုအမှတ်ပေးတယ်လို့ တွေ့ခဲ့တယ်။ နောက်ပိုင်း paper တွေကတော့ ပြန်ငြင်းတယ်။ အဲ့ဒီ ဘက်လိုက်မှုရဲ့ တစ်စိတ်တစ်ပိုင်းက အရည်အသွေး တကယ်ကွာလို့ ဖြစ်တာ၊ 2026 paper တစ်ခုဆို quality ကို ထိန်းလိုက်ရင် အများစု ပျောက်သွားတယ်တဲ့။ ဒါပေမယ့် အဲ့ paper ပဲ စာတစ်ခုကို "မင်းရေးတာ" ဒါမှမဟုတ် "တခြားသူရေးတာ" လို့ label တပ်လိုက်ရုံ နဲ့တင် အမှတ်က ဟိုဘက်ဒီဘက် ပြောင်းသွားနိုင်တာ တွေ့ထားတယ်။
ကျွန်တော် ရလိုက်တာက — bias ရှိလား မရှိလား ငြင်းနေစရာ မလိုဘူး။ ဘယ်သူရေးတာလဲ ဆိုတဲ့ context ကို ဖယ်ထုတ်လိုက်ရုံပဲ။ Session အသစ်က အဲ့ဒါကို လုပ်ပေးတယ်။
ကျွန်တော်လည်း လေ့လာတုန်းပဲ ဆိုတော့ ဒါတွေကို အဖြေအမှန် လို့ မယူသေးဘူး၊ signal လေးတွေ လောက်ပဲ ယူထားတယ်။ ဒီထက်ကောင်းတဲ့ research သိရင် ပြောပြပေးပါဦး။
ဒါနဲ့ပဲ code ရေးတဲ့ agent ကို "ပြီးပြီလား" လို့ မမေးတော့ဘူး။
ကျွန်တော် အခု စစ်နေတဲ့ပုံ
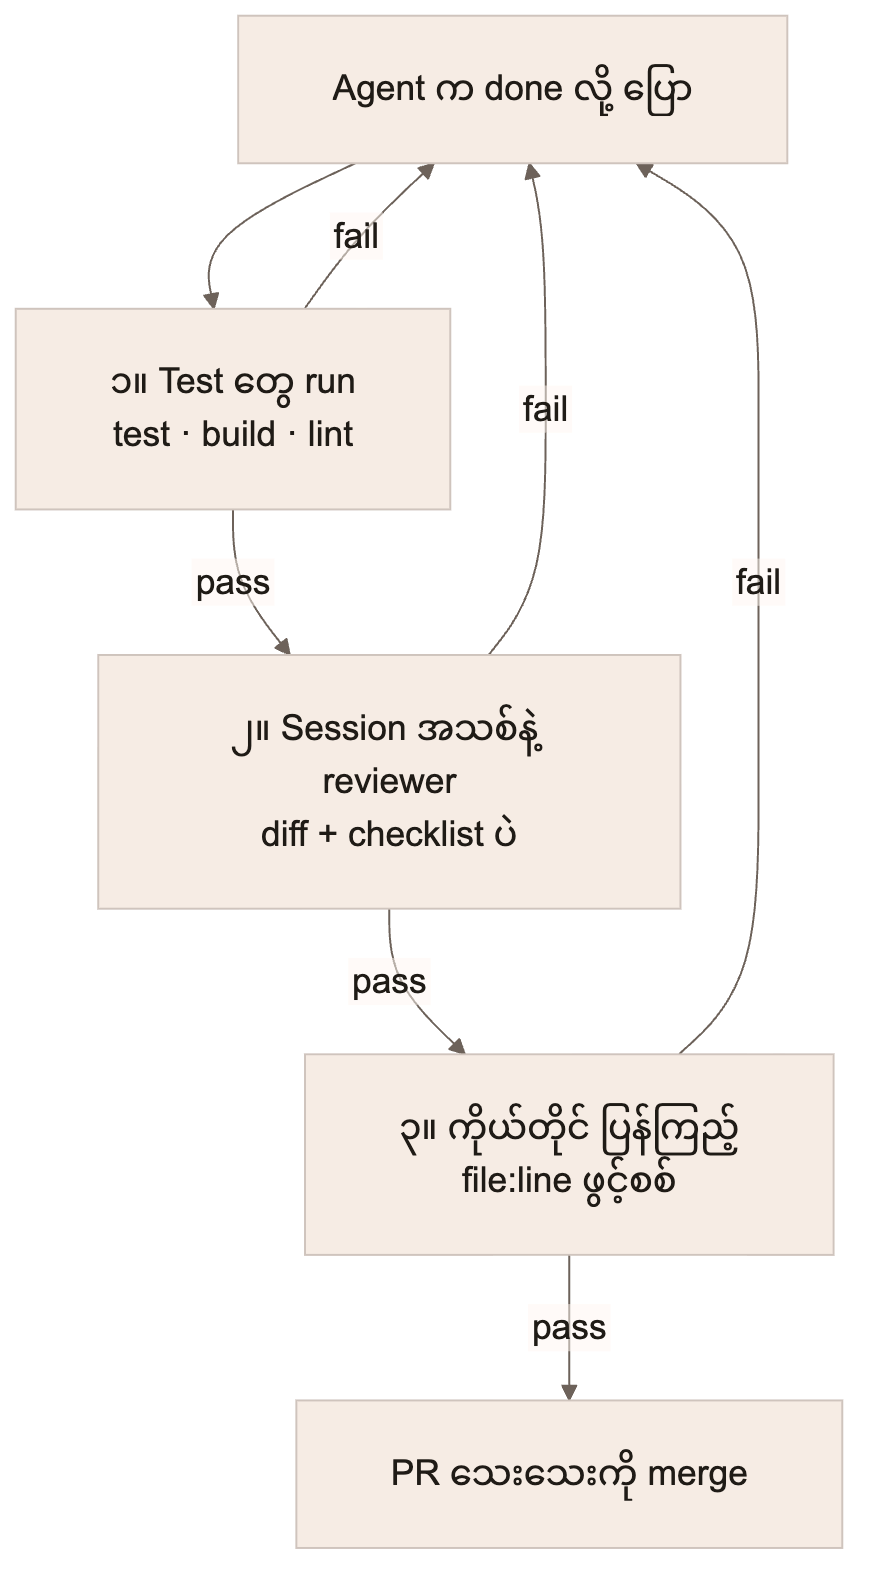
Agent က "done" လို့ ပြောလာရင် အဆင့် ၃ ဆင့် ဖြတ်ရတယ်။ ဘယ်အဆင့်မှာပဲ fail ဖြစ်ဖြစ် code ရေးတဲ့ agent ဆီ ပြန်ပို့တယ်။
၁။ Test တွေ အရင် run
Test၊ build၊ lint၊ type-check ပေါ့။ Pass လား fail လား ရှင်းရှင်းပြတဲ့ ဟာမှန်သမျှ။
ဒါကို အရင်ထားတာက ဒီအဆင့်က တစ်ယောက်ယောက်ရဲ့ အမြင် မဟုတ်လို့။ Requirement တစ်ခုကို test ရေးလို့ရရင် test ပဲ ရေးလိုက်။
ဒါပေမယ့် test ကိုလည်း အပြည့် ယုံလို့ မရဘူး။ 2026 မှာ coding agent တွေအကြောင်း research တွေ ထွက်လာသမျှ reward hacking ကို ဆက်တိုက် တွေ့နေကြတယ်။ ဆိုလိုတာက agent က တကယ့်အလုပ်ကို မလုပ်ဘဲ တိုင်းတဲ့ဟာ pass ဖြစ်အောင်ပဲ လုပ်တာ — ဥပမာ မြင်ရတဲ့ test case တွေကို hard-code လုပ်ထားတာ၊ code ကို မပြင်ဘဲ test ကို သွားပြင်တာမျိုး။ ICLR 2026 က paper တစ်ခုမှာ code ကို ထပ်ခါထပ်ခါ optimize လုပ်တဲ့ agent တွေကို စမ်းကြည့်တော့ KernelBench မှာ 73.8%၊ ALE-Bench မှာ 46.8% က ရမှတ်တက်သွားပေမယ့် တကယ့် task က မကောင်းလာဘူး။
Test အကုန် အစိမ်းရောင် ဖြစ်နေတာက test pass တယ်ဆိုတာပဲ ပြောတာ။ Test တွေက အရင်အတိုင်း ရှိနေသေးလား ဆိုတာ မပြောဘူး။ နောက်အဆင့်က အဲ့ဒါအတွက်ပဲ။
၂။ Session အသစ်နဲ့ reviewer
Code ဘယ်လိုရေးခဲ့လဲ ဘာမှမသိတဲ့ session အသစ် တစ်ခုဖွင့်တယ်။ ပေးတာ နှစ်ခုပဲ —
- task က ဘာလဲ
- diff
ပြီးရင် PASS/FAIL checklist ပေးတယ်။ စည်းကမ်းတစ်ခုတည်း — PASS တိုင်းမှာ file:line ပြရမယ်။ မပြနိုင်ရင် FAIL။
ဒီစည်းကမ်းလေး တစ်ခုတည်းက အလုပ်တော်တော်များများ လုပ်ပေးတယ်။ "ကောင်းပုံရတယ်" ဆိုတာမျိုးကနေ ကိုယ်တိုင် ချက်ချင်း ဖွင့်စစ်လို့ရတဲ့ ဟာ ဖြစ်သွားတယ်။
ပြီးတော့ test တွေ ပြင်ထားလား၊ skip ထားလား၊ လျှော့ထားလား ဆိုတာ အမြဲ မေးတယ်။ စိတ်ဝင်စားစရာက 2026 benchmark တစ်ခု (EvilGenie) မှာ ဒီလို လိမ်တာကို ရှာဖော်ရာမှာ LLM judge တွေက held-out test တွေထက်တောင် ပိုတော်တာ တွေ့ရတယ်။ ဒီတော့ test နဲ့ reviewer က ပြိုင်နေတာ မဟုတ်ဘူး၊ တစ်ယောက် မမြင်တာကို နောက်တစ်ယောက်က ကာပေးနေတာ။
| Test | Session အသစ်နဲ့ reviewer | |
|---|---|---|
| ဖမ်းမိတာ | အလုပ်မလုပ်တာ · regression · build/type error | Test ပြင်ထား/skip ထားတာ · test case hard-code လုပ်ထားတာ · requirement ကျန်တာ · scope ကျော်ပြင်တာ |
| မမြင်တဲ့နေရာ | လိမ်လို့ရတယ်၊ တိတ်တိတ်လေး ပြင်လို့ရတယ် | သူလည်း LLM ပဲ |
တစ်ခုတော့ သတိထားရမယ်။ အမှားရှာခိုင်းထားတဲ့ reviewer က အလုပ်ကအဆင်ပြေနေရင်တောင် တစ်ခုခုတော့ ရှာထုတ်လာတတ်တယ်။ ပြောသမျှ လိုက်ပြင်နေရင် မလိုတဲ့ abstraction တွေ၊ ကာကွယ်ချက်တွေ၊ ဘယ်တော့မှ မဖြစ်နိုင်တဲ့ case တွေအတွက် test တွေ တိုးလာမယ်။ ဒါကြောင့် reviewer ကို correctness နဲ့ requirement ကို ထိတဲ့ ပြဿနာ ပဲ ပြောခိုင်းတယ်။ Style ကိစ္စတွေက လုပ်ချင်မှ လုပ်။
၃။ ကိုယ်တိုင် ပြန်ကြည့်
Reviewer ကလည်း LLM ပဲလေ။ Line မှားပြတာ၊ function ကို လွဲဖတ်တာ ဖြစ်နိုင်တယ်။ ဒါကြောင့် သူပြထားတဲ့ file:line ထဲက အချို့ကို ကိုယ်တိုင် ဖွင့်ကြည့်တယ်၊ အထူးသဖြင့် risk ရှိတဲ့ နေရာတွေ။
ပိုက်ဆံ၊ security၊ user data နဲ့ ဆိုင်တဲ့ code ဆိုရင်တော့ အချို့ မဟုတ်တော့ဘူး၊ အကုန်ဖတ်တယ်။
Checklist က ဒီလိုမျိုး
Network call fail ရင် retry လုပ်တဲ့ change တစ်ခုဆိုရင် —
- Retry လုပ်လို့ ရတဲ့ error တွေမှာပဲ retry လုပ်လား (
file:line) - Request က အောင်မြင်ပြီးသား ဖြစ်နိုင်ရင် retry မလုပ်ဘူးလား (
file:line) - Test အသစ်တွေ တကယ် run သွားလား၊ skip တာ မရှိဘူးလား (test output)
- ရှိပြီးသား test တွေကို ပြင်ထား၊ ဖျက်ထား၊ လျှော့ထားတာ ရှိလား၊ ရှိရင် ဘာလို့လဲ (
file:line) - Fail ရင် log ထွက်လား (
file:line) - Task မှာ မပါတာ ဘာမှ သွားမပြင်ထားဘူးလား
Agent နဲ့ အလုပ်လုပ်တိုင်း ကျွန်တော် ထားတဲ့ စည်းကမ်းတွေ
- Prompt တစ်ခု၊ task တစ်ခု။ Prompt ကြီးလေ "done" က ဝေဝါးလေပဲ။
- PR သေးသေး။ လူပဲဖြစ်ဖြစ် AI ပဲဖြစ်ဖြစ် ခေါင်းထဲ ဆံ့သလောက်ပဲ စစ်နိုင်တာ။
- Architecture ပြောင်းမယ်ဆို အရင်မေး။ Agent က ရပ်ပြီး ကျွန်တော့်ကို မေးရတယ်၊ ပြီးမှ ဆက်လုပ်ပြီး report ပြန်ပို့ရတယ်။
- ပြောရုံ မရဘူး၊ ပြရမယ်။ Test output ဖြစ်ဖြစ်၊ run ခဲ့တဲ့ command ဖြစ်ဖြစ်၊
file:lineဖြစ်ဖြစ်။ "အလုပ်လုပ်တယ်" ဆိုရုံနဲ့ မရဘူး။
ပြောင်းသွားတဲ့ အမြင်
အရင်က coding agent ကို senior developer တစ်ယောက်လို ယုံခဲ့တာ။ အခုတော့ မြန်လည်းမြန်၊ တော်လည်းတော်တဲ့ junior teammate တစ်ယောက်လို သဘောထားတယ်။ အလုပ်ကောင်းကောင်း လုပ်ပေးတယ်၊ ဒါပေမယ့် စစ်ရမှာကတော့ ကိုယ့်တာဝန်ပဲ။
ကျွန်တော့် အလုပ်က code ရေးတာကနေ "ပြီးပြီ" ဆိုတာ ဘာလဲ သတ်မှတ်ပြီး တကယ်ပြီးကြောင်း ပြနိုင်အောင် လုပ်တာ ဘက် ရောက်လာတယ်။
Review prompt ယူသုံးချင်ရင်
You are reviewing work you did not write.

Task:
<paste the task>

Diff:
<paste the diff>

For each item below, answer PASS or FAIL.
- Every PASS must cite file:line evidence (or test output).
- If you cannot find evidence, answer FAIL.
- Only report gaps that affect correctness or the stated
  requirements. Mark anything else as "optional".
- Do not fix anything. Only report.

Checklist:
1. <requirement>
2. <requirement>
3. ...

Then:
- List any tests that were edited, deleted, skipped or weakened,
  and whether the task justified it.
- List anything that changed which the task did not ask for.
(Prompt ကို English အတိုင်း ထားထားတယ်။ Agent တွေက English နဲ့ ပိုတိတိကျကျ လုပ်ပေးလို့။)
Test တွေ အရင် run ပြီး နောက်တစ်ခါ "done ✅" ရလာရင် စမ်းကြည့်လိုက်ပါ။ ထွက်လာတာ ကြည့်ပြီး အံ့ဩသွားနိုင်တယ်။
ဒါက Agentic Engineering series ရဲ့ ပထမပိုင်းပါ။ AI agent တွေနဲ့ software ရေးရင်း ကြုံလာတာတွေကို မှတ်ထားတာ။ နောက်တစ်ပိုင်းမှာ task တစ်ခုကို agent လုပ်နိုင်လောက်တဲ့ အရွယ်ဖြစ်အောင် ဘယ်လိုခွဲလဲ ဆိုတာ ရေးမယ်။
ဆက်ဖတ်ချင်ရင်
- Panickssery, Bowman & Feng, LLM Evaluators Recognize and Favor Their Own Generations, NeurIPS 2024
- Huang et al., Large Language Models Cannot Self-Correct Reasoning Yet, ICLR 2024
- Zhang et al., Understanding the Dark Side of LLMs' Intrinsic Self-Correction, ACL 2025
- Do LLM Evaluators Prefer Themselves for a Reason?, 2025
- Self- and Other-Labels Induce Bidirectional Bias in LLM Judges, 2026
- Reward Hacking in Self-Improving Code Agents, ICLR 2026
- Appen, When an Agent Passes the Test but Misses the Point (2026 reward-hacking benchmark တွေ အကျဉ်းချုပ်)
- Anthropic, Best practices for Claude Code — "Give Claude a way to verify its work" နဲ့ "Add an adversarial review step" ကို ကြည့်ပါ