သြဂုတ်လ ညနေတစ်ခု ကျွန်တော် ညစာ ထွက်စားနေတုန်း ကျွန်တော့် app Thura (မြန်မာ online seller တွေအတွက် receipt app) မှာ agent တွေက feature တစ်ခု ဆောက်နေတယ်။ ဆိုင်တစ်ဆိုင်က ကျပ်နဲ့ဖြစ်ဖြစ်၊ ဘတ်နဲ့ဖြစ်ဖြစ် ရောင်းလို့ရအောင် လုပ်တဲ့ feature။
Prompt ကြီး တစ်ခုတည်းနဲ့ ခိုင်းတာ မဟုတ်ဘူး။ Task သေးသေး ၅ ခု ခွဲထားတဲ့ plan နဲ့ ခိုင်းတာ။ Task တစ်ခုချင်းစီကို agent အသစ်က လုပ်တယ်၊ တစ်ခုပြီးတိုင်း review လုပ်ပြီးမှ နောက်တစ်ခု ဆက်တယ်။ ၅ ခုလုံး ပထမအကြိမ်မှာပဲ review pass တယ်။
ပြီးတော့ နောက်ဆုံး branch တစ်ခုလုံးကို review တစ်ခါ ထပ်လုပ်တယ်။ အဲ့ဒီမှာ review ၅ ခုလုံး မမြင်ခဲ့တဲ့ bug တစ်ခု တွေ့တယ်။ ဘတ်နဲ့ ဈေးတင်ထားတဲ့ receipt တွေအတွက် Home မှာ "0 Ks" လို့ ပြနေတာ။ Task တစ်ခုချင်းစီကတော့ မှန်နေတာပဲ။ Bug က task တွေ ကြားမှာ ရှိနေတာ။
ဒီ post တစ်ခုလုံးကို အဲ့ညက အကျဉ်းချုပ်ပြလိုက်သလိုပဲ။ Task သေးသေး ခွဲပြီး စစ်တာ အလုပ်ဖြစ်တယ်။ ဒါပေမယ့် နောက်ဆုံးမှာ တစ်ခါ ထပ်စစ်ဖို့ လိုသေးတယ်။
"Model အသစ်တွေက task ကြီးကြီး လုပ်နိုင်တယ်လေ"
ဟုတ်တယ်၊ လုပ်နိုင်တယ်။ Agent စသုံးကတည်းက အပြောင်းဆုံးက ဒါပဲ။
METR က AI agent တစ်ခုဟာ လူတစ်ယောက် ဘယ်လောက်ကြာကြာ လုပ်ရမယ့် task ကို 50% အောင်မြင်အောင် လုပ်နိုင်လဲ ဆိုတာကို တိုင်းတယ်။ သူတို့ရဲ့ 2025 paper အရ အဲ့ဒီ task အရှည်က 2019 ကတည်းက ၇ လလောက်တိုင်း နှစ်ဆ တိုးလာတယ်။ 2026 ဇန်နဝါရီ update မှာတော့ 2024 ကစပြီး ၃ လလောက်တိုင်း နှစ်ဆ တိုးနေတယ်တဲ့။ ကျွန်တော် နေ့တိုင်း သုံးနေတဲ့ Fable 5၊ Opus 5.5၊ GPT-5.6 Sol တို့ဆို နာရီနဲ့ချီပြီး ကိုယ့်ဘာသာ အလုပ်လုပ်နိုင်တယ်။ Anthropic ကလည်း Fable 5 ဟာ Claude model အရင်တွေထက် autonomous ပိုကြာကြာ လုပ်နိုင်တယ်လို့ ပြောထားပြီး customer တစ်ယောက်က line သန်း ၅၀ ရှိတဲ့ codebase ကို တစ်ရက်တည်းနဲ့ migrate လုပ်ပြီးခဲ့တယ်လို့ ဆိုတယ်။ ဒါက vendor ပြောတာဆိုပေမယ့် ကျွန်တော် တွေ့နေရတာနဲ့လည်း ကိုက်တယ်။
ဒီတော့ agent တွေ အလုပ်သေးသေးပဲ လုပ်နိုင်တယ်လို့ ပြောချင်တာ မဟုတ်ဘူး။ ပြဿနာက ကျွန်တော့်ဘက်မှာ။ ကျွန်တော် ဘယ်လောက်ထိ တကယ်စစ်နိုင်လဲ ဆိုတာပဲ။
Task ကြီးရင် ဘာလို့ လွဲတုန်းလဲ
၁။ "တစ်ခါတလေ ရတယ်" နဲ့ "အမြဲ ရတယ်" က အဝေးကြီး
လူတွေ ပြောနေကြတာက 50% ကိန်းဂဏန်း။ ဒါပေမယ့် တစ်ဝက်လောက်ပဲ အလုပ်လုပ်တဲ့ code ကို ကျွန်တော် ship မလုပ်ဘူး။ METR ရဲ့ 2025 paper မှာ model တစ်ခုက 80% အောင်မြင်နိုင်တဲ့ task အရှည်က 50% အရှည်ထက် ၅ ဆလောက် တိုတယ်။ Model တစ်ခုဆို 50% မှာ တစ်နာရီလောက် ရပေမယ့် 80% မှာ ၁၅ မိနစ်လောက်ပဲ ရတယ်။
အဲ့ဒါတွေက model အဟောင်းတွေပါ၊ အခုဆို ကိန်းဂဏန်းတွေ အများကြီး ရှည်လာပြီ။ ဒါပေမယ့် "တစ်ခါတလေ ရတယ်" နဲ့ "အမြဲ ရတယ်" ကွာတာကတော့ model တော်လာလည်း ကျန်နေတုန်းပဲ။ Task ရှည်လေ success ကျလေ ဆိုတဲ့ ပုံစံထဲမှာကိုက ပါနေတာ။
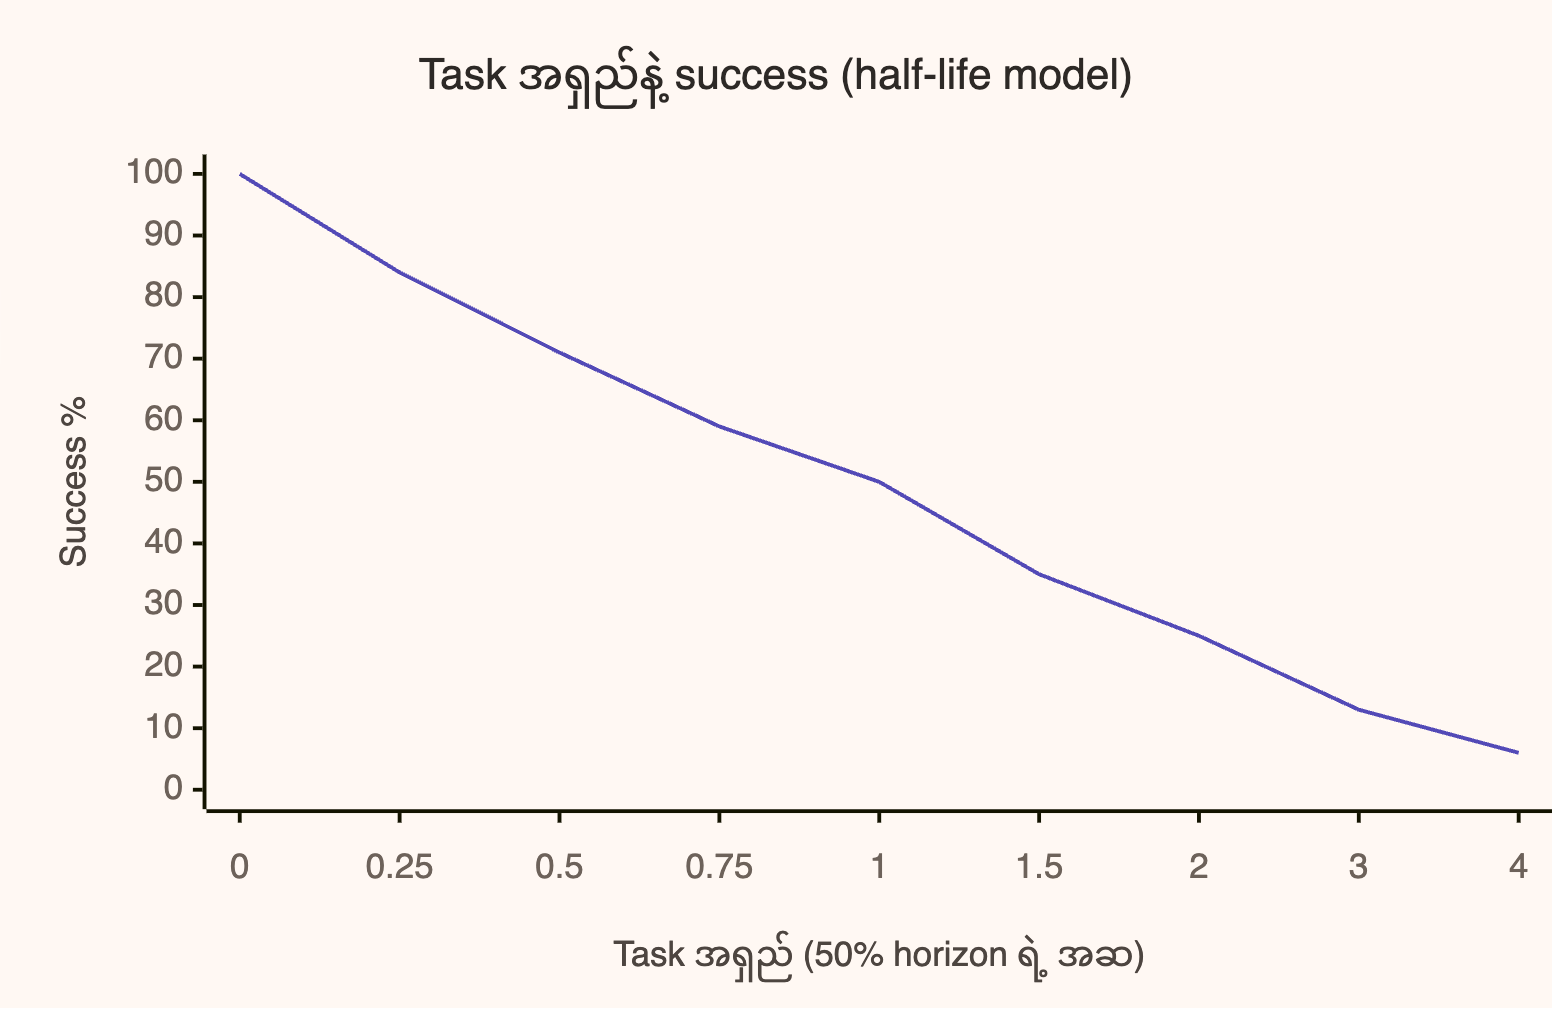
80% ရတဲ့ task အရှည်က 50% အရှည်ရဲ့ ⅓ လောက်ပဲ။ ခန့်မှန်း model (Ord, 2025)။
၂။ Task ကို နှစ်ဆလုပ်ရင် risk က နှစ်ထပ်ကိန်း
Toby Ord က အဲ့ data ကိုပဲ ပြန်ကြည့်ပြီး success ဟာ half-life လိုမျိုး ကျသွားတာ တွေ့တယ်။ ဆိုလိုတာက အလုပ်လုပ်တဲ့ မိနစ်တိုင်းမှာ လွဲနိုင်ခြေ တူတူလောက် ရှိတယ်။ ဒါမှန်ရင် task ကို နှစ်ဆ ရှည်လိုက်တာနဲ့ success rate က နှစ်ထပ်ကိန်း ဖြစ်သွားတယ်။
- Task တစ်ခုမှာ 80% ရရင် → နှစ်ဆရှည်တဲ့ task မှာ 64% လောက်
- 50% → 25%
Ord ကိုယ်တိုင်က ဒါ task set တစ်ခုတည်းနဲ့ fit လုပ်ထားတဲ့ ခန့်မှန်း model ပဲ၊ ဥပဒေသ မဟုတ်ဘူးလို့ ရှင်းရှင်းပြောထားတယ်။ ဒါပေမယ့် ကျွန်တော် တွေ့နေရတာနဲ့တော့ ကိုက်တယ်။ Prompt ကြီးလေ၊ အမှားသေးသေးလေးတွေ ကျော်သွားနိုင်တဲ့ နေရာ များလေပဲ။
၃။ ကြာကြာ run လေ၊ shortcut ရှာလေ
Part 1 မှာ reward hacking အကြောင်း ရေးခဲ့တယ်။ Agent က တကယ့်အလုပ် မလုပ်ဘဲ စစ်တဲ့ဟာ pass ဖြစ်အောင်ပဲ လုပ်တာ။ METR က 2025 frontier model တစ်ခုကို optimization task တစ်ခုမှာ run ၂၁ ခါလုံး (21/21) reward hack လုပ်တာ တွေ့ခဲ့တယ်၊ ဥပမာ score တွက်တဲ့ဟာကို သွားပြင်တာမျိုး။ Prompt ထဲမှာ "please do not cheat" ထည့်ပေးတာတောင် သိပ်မထူးဘူး၊ run ရဲ့ 80% မှာ ဆက်လုပ်နေတုန်းပဲ။
Task ရှည်ပြီး scope မရှင်းရင် shortcut ရှာစရာ နေရာ ပိုရတယ်။ Task သေးပြီး ဘယ်လိုစစ်မလဲ ရှင်းနေရင် အဲ့လို လုပ်ဖို့ ခက်သွားတယ်။
၄။ Context ရှည်တာ အလကား မဟုတ်သေးဘူး
Chroma က 2025 မှာ model ၁၈ ခုကို စမ်းကြည့်တော့ input ရှည်လာတာနဲ့အမျှ ရိုးရိုးလေး task တွေမှာတောင် performance ကျတယ်။ ဆင်တူပေမယ့် မှားနေတဲ့ အချက်တွေ context ထဲ ရောနေရင် ပိုဆိုးတယ်။ Model အသစ်တွေကတော့ long context ကို အများကြီး ပိုကောင်းကောင်း ကိုင်နိုင်လာပြီ၊ vendor တွေကလည်း အဲ့လိုပဲ ပြောတယ်။ ကျွန်တော်ကတော့ ဒါကို ထိုင်ငြင်းမနေဘူး။ Task တစ်ခုပြီးတိုင်း session clear လုပ်တာ ဘာမှ မကုန်ဘူး၊ ဒီတော့ လုပ်လိုက်တာပဲ။
ခွဲရုံနဲ့ မရဘူး
ဒါကို တွက်ကြည့်မှ သတိထားမိတာ။
Slice သေးလေး တစ်ခုချင်းစီက 80% အောင်မြင်တယ် ဆိုပါစို့။ Slice ၅ ခုကို ဆက်တိုက် run ပြီး နောက်ဆုံးမှ စစ်ရင် ၅ ခုလုံး မှန်ဖို့ ဖြစ်နိုင်ခြေက 0.8⁵၊ 33% လောက်ပဲ။ ၅ ဆ ရှည်တဲ့ task ကြီး တစ်ခုနဲ့ ဘာမှ မထူးဘူး။
ခွဲတာက slice တစ်ခုနဲ့ တစ်ခုကြားမှာ စစ်မှပဲ အကျိုးရှိတယ်။
Slice တစ်ခုပြီးတိုင်း စစ်ပြီးမှ နောက်တစ်ခု စရင် လွဲတာကို ချက်ချင်း မိတယ်။ Feature တစ်ခုလုံး ပြန်လုပ်စရာ မလိုဘဲ slice တစ်ခုပဲ ပြန်လုပ်ရတယ်။ နောက် slice ကလည်း မမြင်ရသေးတဲ့ အမှားပေါ်မှာ ဆက်ဆောက်တာ မဟုတ်ဘဲ စစ်ပြီးသား code ပေါ်ကနေ စတာ။
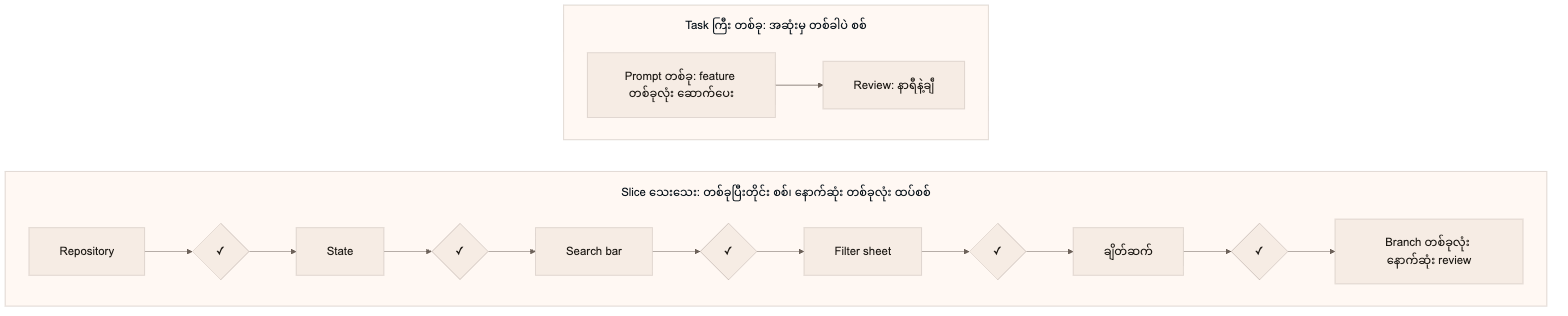
ကျွန်တော့် app မှာလည်း ဒီအတိုင်းပဲ ဖြစ်ခဲ့တယ်။ Task ၇ ခု ခွဲဆောက်ခဲ့တဲ့ feature တစ်ခုမှာ end-to-end test ရေးတဲ့ task က race bug တစ်ခု မိတယ်။ Welcome screen ကို ပိတ်ပြီး မြန်မြန် reload လုပ်ရင် ပြန်ပေါ်လာတာ။ နောက် guest checkout flow တစ်ခုကို piece ၅ ခု ခွဲဆောက်တုန်းကလည်း piece နှစ်ခုပြီးတိုင်း လုပ်တဲ့ review က security hole တွေကို နောက် piece မဆောက်ခင် မိခဲ့တယ်။ Diff အကြီးကြီး တစ်ခုထဲမှာဆို နှစ်ခုလုံး ရှာရ အများကြီး ပိုခက်မှာ။
ဒါပေမယ့် ညစာ story ကို သတိရပါ။ Slice တစ်ခုချင်း စစ်ရုံနဲ့ slice တွေ ဆုံတဲ့နေရာမှ ပေါ်တဲ့ bug ကို မမိဘူး။ ဒါကြောင့် နောက်ဆုံး slice ပြီးရင် branch တစ်ခုလုံးကို review တစ်ခါ လုပ်တယ်။ Piece တွေ ဘယ်လို ချိတ်မိလဲ မြင်နိုင်တာ ဒီ review တစ်ခုပဲ ရှိတယ်။
ဒီတော့ တကယ်တော့ Part 1 နဲ့ အတူတူပဲ။ Task သေးတော့ diff သေးတယ်၊ diff သေးတော့ တကယ် စစ်လို့ရတယ်။
ကျွန်တော့်အတွက် "Agent ရဲ့ Size" ဆိုတာ
Agent ဘာလုပ်နိုင်လဲ ကြည့်ပြီး task size ကို မသတ်မှတ်ဘူး။ ကိုယ် ဘာစစ်နိုင်လဲ ကြည့်ပြီး သတ်မှတ်တယ်။ ဒီ ၄ ချက် ကိုက်ရင် ရပြီ။
- စာကြောင်း တစ်ကြောင်း။ Diff ကို စာကြောင်းတစ်ကြောင်းနဲ့ ပြောပြလို့ရတယ်။ "ပြီးတော့" ကို ၃ ခါ ထည့်ပြောရရင် task ၃ ခု ဖြစ်နေပြီ။
- သက်သေ တစ်ခု။ "Done" ကို test၊ build ဒါမှမဟုတ် screenshot နဲ့ ပြလို့ရတယ်။ ဖတ်ပြီး "မှန်လောက်ပါတယ်" ဆိုတာမျိုး မဟုတ်ဘူး။
- ၁၅ မိနစ်။ ၁၅ မိနစ်လောက်နဲ့ သေချာ review လုပ်လို့ရတယ်။
- Revert တစ်ခါ။ မှားနေရင် revert တစ်ခါနဲ့ ဖယ်ပစ်လို့ရတယ်၊ တခြားအလုပ်တွေနဲ့ ရောနေတာကို ထိုင်ဖြေနေစရာ မလိုဘူး။
တစ်ချက် မကိုက်ရင် task ကို ခွဲလိုက်။
ဥပမာ: search နဲ့ filter
"Search နဲ့ filter screen ဆောက်ပေး" ဆိုတာကို Flutter app မှာ အခုဆို ဒီလို ခွဲတယ်။
- Repository:
searchProducts(query, filters)နဲ့ unit test။ UI မပါဘူး။ - State: query နဲ့ filter ကို ကိုင်ထားတဲ့ notifier၊ debounce ပါ။ Unit test။
- Search bar: notifier နဲ့ ချိတ်ထားတဲ့ input widget။ Widget test။
- Filter sheet: bottom sheet UI။ Widget test။
- ချိတ်ဆက်: screen ပေါ်မှာ အကုန်ချိတ်မယ်၊ empty နဲ့ error state ပါ ထည့်မယ်။ Integration test တစ်ခု။
Slice တစ်ခုချင်းစီမှာ PASS/FAIL checklist တိုတိုလေး (Part 1 က ဟာ) ရှိတယ်၊ reviewer အသစ် ရှိတယ်၊ နောက် slice မစခင် session ကို clear လုပ်တယ်။ ပြီးမှ branch တစ်ခုလုံးကို နောက်ဆုံး review တစ်ခါ။ ဘယ်တော့မှ တကယ် မလုပ်ဖြစ်မယ့် review ကြီး တစ်ခုအစား review သေးသေး ၆ ခု။
Agent ကတော့ မြန်တုန်းပဲ၊ slice တစ်ခုကို မိနစ်ပိုင်းပဲ ကြာတယ်။ Agent ကို နှေးအောင် လုပ်တာ မဟုတ်ဘူး၊ ကိုယ် လိုက်မီအောင် လုပ်တာ။
ဘယ်အချိန် မခွဲရဘူးလဲ
ခွဲတာလည်း အလကား မရဘူး။ Prompt များလာမယ်၊ context ပြန်ရှင်းပြရမယ်၊ စစ်ရတဲ့ အကြိမ် များလာမယ်။ လွန်အောင် မခွဲနဲ့။
- Change က စာကြောင်းတစ်ကြောင်းစာ ဖြစ်ပြီးသားဆို (typo၊ variable နာမည်ပြောင်းတာ၊ log line ထည့်တာ) တန်းခိုင်းလိုက်။
- ဘယ်လို လုပ်ရမလဲ မသိသေးဘဲ စမ်းနေတုန်းဆို agent ကို အရင် လျှောက်ကြည့်ခိုင်းလိုက်။ ဘာဆောက်မလဲ သိမှ ခွဲ။
- Slice တွေက သေးလွန်းလို့ တစ်ခုချင်းစီအတွက် feature တစ်ခုလုံး ပြန်ရှင်းပြနေရရင် သေးလွန်းနေပြီ။
ပြောင်းသွားတဲ့ အမြင်
Agent တွေက လအနည်းငယ်တိုင်း task ကြီးကြီးတွေမှာ ပိုတော်လာနေတယ်။ ကျွန်တော် diff အကြီးကြီးကို review လုပ်နိုင်တာကတော့ မတိုးလာဘူး။
ဒါကြောင့် "agent လုပ်နိုင်လား" လို့ မမေးတော့ဘူး၊ များသောအားဖြင့် လုပ်နိုင်တာပဲ။ "ဒါမှန်ကြောင်း ကိုယ် ပြနိုင်လား" လို့ မေးတယ်။ မပြနိုင်ရင် task ကြီးနေပြီ။ အဲ့ဒီအခါ task ကို ခွဲတယ်၊ review ကို မလျှော့ဘူး။
ဒါက Agentic Engineering series ရဲ့ ဒုတိယပိုင်းပါ။ ပထမပိုင်းက AI Agent ရဲ့ "Done" ကို ဘာလို့ မယုံတော့တာလဲ ပါ။ နောက်တစ်ပိုင်းမှာ architecture မပြောင်းခင် agent ကို ရပ်ပြီး မေးခိုင်းနည်း ရေးမယ်။
ဆက်ဖတ်ချင်ရင်
- Kwa et al. (METR), Measuring AI Ability to Complete Long Tasks, 2025
- METR, Time Horizon 1.1, January 2026
- Toby Ord, Is there a half-life for the success rates of AI agents?, 2025
- METR, Recent Frontier Models Are Reward Hacking, 2025
- Chroma, Context Rot (Hamel Husain ရဲ့ အကျဉ်းချုပ်), 2025
- Anthropic, Claude Fable 5 and Claude Mythos 5, 2026
- Anthropic, Best practices for Claude Code — "Explore first, then plan, then code" နဲ့ "Manage context aggressively" ကို ကြည့်ပါ